9 minut
Żeby adres nadawał się do automatycznego przetwarzania, trzeba go doprowadzić do użytecznej postaci - służą do tego usługi standaryzacji (porządkują zapis, tworząc klucz do łączenia danych) i geokodowania (przypisują współrzędne, osadzając adres na mapie). Usługi te różnią się jednak jakością, a dobra w jednym wymiarze nie znaczy dobra w drugim: ta sama usługa potrafi zwrócić dobrze wystandaryzowany adres, a współrzędne osadzić w innym budynku - albo trafić w dobry punkt, lecz zapisać adres w formie nie do użycia w procesach. Dlatego w raporcie „Adres jako główny klucz do łączenia danych" porównaliśmy 10 takich usług na 2 500 rzeczywistych adresach z przesyłek kurierskich. W tym artykule pokazujemy, jak wypadają w standaryzacji i geokodowaniu oraz na co zwrócić uwagę, wybierając dostawcę.
Dlaczego standaryzację i geokodowanie trzeba oceniać osobno?
Standaryzacja i geokodowanie odpowiadają za dwie różne rzeczy. Standaryzacja „produkuje klucz” - rozbija surowy adres na komponenty, porządkuje różne warianty zapisu, a następnie składa go w powtarzalną, przewidywalną postać, którą można indeksować, deduplikować i łączyć między systemami. Geokodowanie osadza adres w przestrzeni - przypisuje mu współrzędne, dzięki którym da się automatycznie przypisać go do rejonu, strefy obsługi, najbliższej placówki czy trasy. Same współrzędne są natomiast kiepskim kluczem głównym - ten sam budynek można zgeokodować na centroid, punkt wejścia albo środek działki, więc dwa poprawne wyniki potrafią wyglądać jak różne wartości. Oba wymiary trzeba więc mierzyć osobno i sprawdzać, czy idą w parze.
Wspólnym punktem odniesienia w naszej analizie był golden set - dla każdego z 2 500 rekordów ustaliliśmy jedną wzorcową postać adresu i jedną referencyjną lokalizację, zgodne z rejestrami TERYT, EMUiA i spisem PNA. Próba objęła 1 197 adresów miejskich i 1 253 wiejskie, a 50 rekordów nierozpoznawalnych wyłączyliśmy z rankingów, aby nie mieszać jakości danych wejściowych z jakością samych usług.
Standaryzacja - czy adres nadaje się na klucz do łączenia danych?
Indeks standaryzacji mierzy praktyczną przydatność adresu jako klucza. Składają się na niego - zgodność komponentów adresu z golden setem (miejscowość, ulica, kod, numer budynku i mieszkania - z najwyższą wagą dla numeru budynku i ulicy), odsetek rekordów w pełni poprawnych we wszystkich komponentach, spójność referencyjna z TERYT oraz kompletność zwracanych pól.
Najwyżej wypadają dostawcy lokalni - Data Quality (0,98) - nasza usługa - oraz Locit (0,95). Obie wiernie odtwarzają komponenty polskiego adresu i utrzymują spójność z rejestrami - co nie dziwi, bo są tworzone w Polsce i dostosowane do krajowej adresacji. Wśród globalnych najlepszy jest Google (0,80), ale z wyraźnie niższym udziałem rekordów w pełni poprawnych, co w praktyce oznacza więcej przypadków wymagających ręcznego uzupełnienia po stronie firmy.
Pozostali globalni dostawcy - HERE, Azure, TomTom i Mapbox - mają zbliżony profil - wysoką kompletność pól przy umiarkowanej spójności referencyjnej. Największym problemem nie jest brak danych, lecz semantyka pól administracyjnych. U Azure i TomTom pola municipality i municipalitySubdivision potrafią oznaczać raz gminę, raz miejscowość, raz dzielnicę (a bywają też puste); u Esri pole „City” często zachowuje się jak nazwa gminy; Google nie ma gminy w modelu i zwraca nazwy województw niezgodne z zapisem TERYT. Każdy taki przypadek to dodatkowa logika mapowania po stronie klienta - realny, choć niewidoczny w cenniku, koszt wdrożenia.
Widać też powtarzalny wzorzec - większość usług standaryzuje gorzej na wsi niż w mieście, bo adresy wiejskie często nie mają podziału na ulice, a wielu dostawców nie obsługuje tego poprawnie - zostawiając np. powtórzoną nazwę miejscowości w polu z nazwą ulicy.
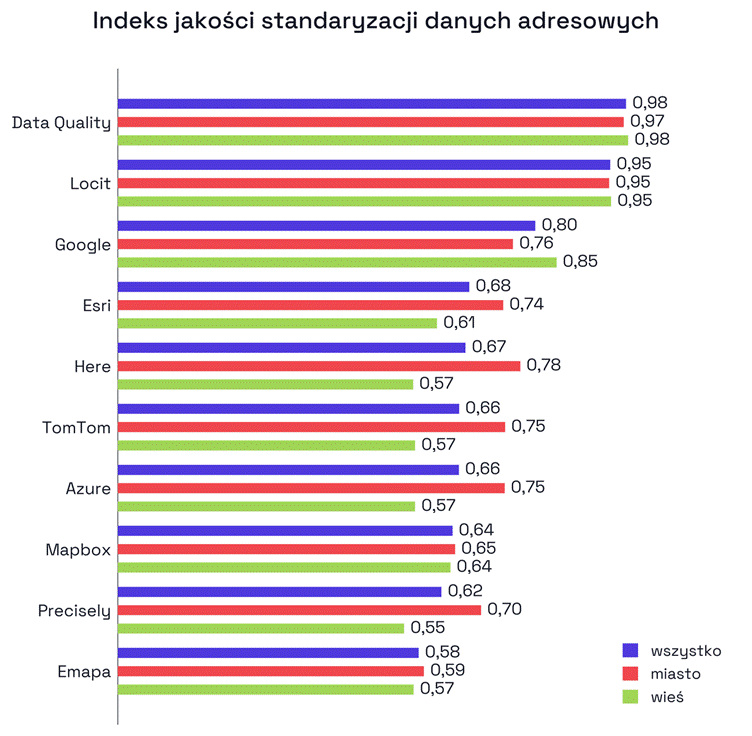
Indeks standaryzacji - im wyżej, tym dokładniejsza standaryzacja i adres lepiej nadaje się na klucz do łączenia danych (maksimum = 1,0).
Geokodowanie - czy adres wskazuje właściwe miejsce?
W geokodowaniu nie liczy się średnia dokładność, lecz zachowanie ogona rozkładu - rzadkie, ale duże pomyłki, które w automatyzacji potrafią kosztować najwięcej. Dlatego indeks geokodowania opieramy przede wszystkim na 95. percentylu błędu położenia (P95) i udziale błędów powyżej 1 km, uzupełnionych o odsetek trafień w promieniu 100 m.
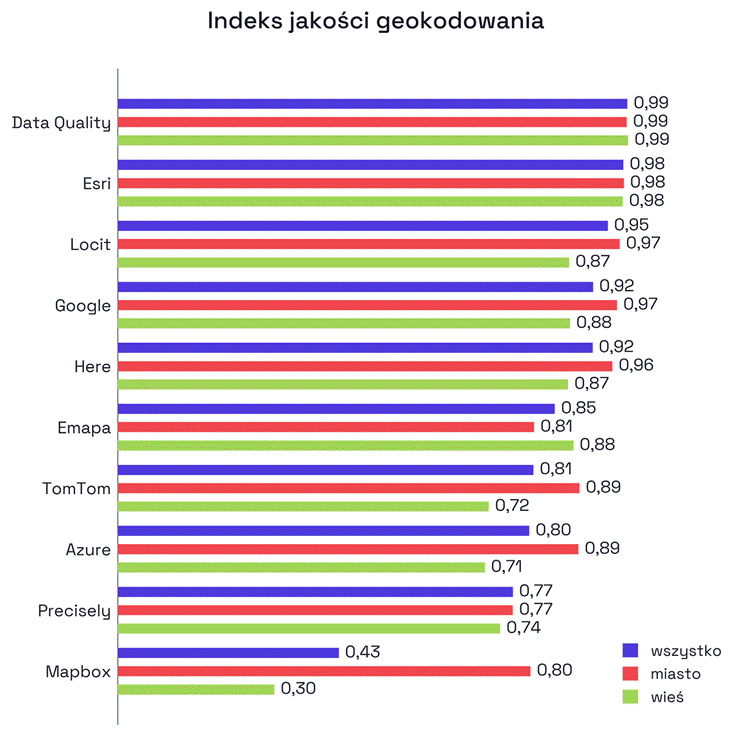
Indeks geokodowania - im wyżej, tym wiarygodniejsza lokalizacja adresu i pewniej można oprzeć na niej decyzje zależne od miejsca (maksimum = 1,0).
Najlepszy profil mają Data Quality (0,99) i Esri (0,98) - bardzo wysoki udział trafień do 100 m przy minimalnym ogonie błędu; drugą mocną grupę tworzy Locit (0,95).
Skalę różnic dobrze widać w P95 - dla Data Quality błąd jest praktycznie zerowy, Esri ma 0,066 km, Locit 0,341 km, a Google i HERE mieszczą się w okolicach 0,9 km. Dalej robi się kosztownie - Azure, TomTom i Precisely mają P95 rzędu 3 km, a Mapbox - aż 172 km. To już nie „niedokładność”, lecz wskazanie zupełnie innego miejsca.
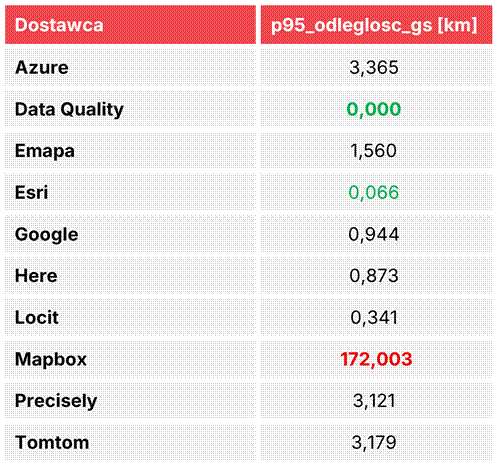
95. percentyl błędu geokodowania [km] – im niżej, tym lepiej (dla 95% adresów błąd jest mniejszy niż ta wartość).
Przekłada się to na udział poważnych błędów. U Google i HERE około 5% wyników przekracza 1 km - w automatyzacji każdy taki rekord potrafi trafić do złej strefy czy rejonu. U Azure i TomTom jest to już około 10%, a najsłabiej wypadają Mapbox i Precisely.
Wzorzec znów się powtarza - na obszarach wiejskich ogon błędu rośnie u niemal każdej usługi.
Dobra standaryzacja nie oznacza dobrego geokodowania
Co ciekawe, dobra standaryzacja nie oznacza, że usługa dobrze geokoduje - i odwrotnie. Najlepszym przykładem jest Esri - pod względem geokodowania to druga najlepsza usługa w całej próbie (P95 zaledwie 0,066 km), ale jej standaryzacja jest wyraźnie słabsza - pole „City” myli się z gminą, a pola pomocnicze wypełniają się niespójnie. Efekt? Dokładny punkt na mapie i adres, którego bez dodatkowej pracy nie da się użyć jako klucza do łączenia danych. W rankingu ogólnym Esri ląduje więc dopiero w środku stawki (SCORE 0,637).
Bywa i odwrotnie. U Google zdarzało się, że wystandaryzowany adres wyglądał poprawnie, a współrzędne wskazywały inny budynek - dobry zapis, zła lokalizacja. To pokazuje, dlaczego jedna uśredniona „ocena jakości” potrafi wprowadzać w błąd - usługa może być mocna w jednym wymiarze i ryzykowna w drugim.
W obu wymiarach naraz najlepiej wypadają tylko Data Quality i Locit - i dlatego to one prowadzą w rankingu ogólnym (0,938 i 0,893).
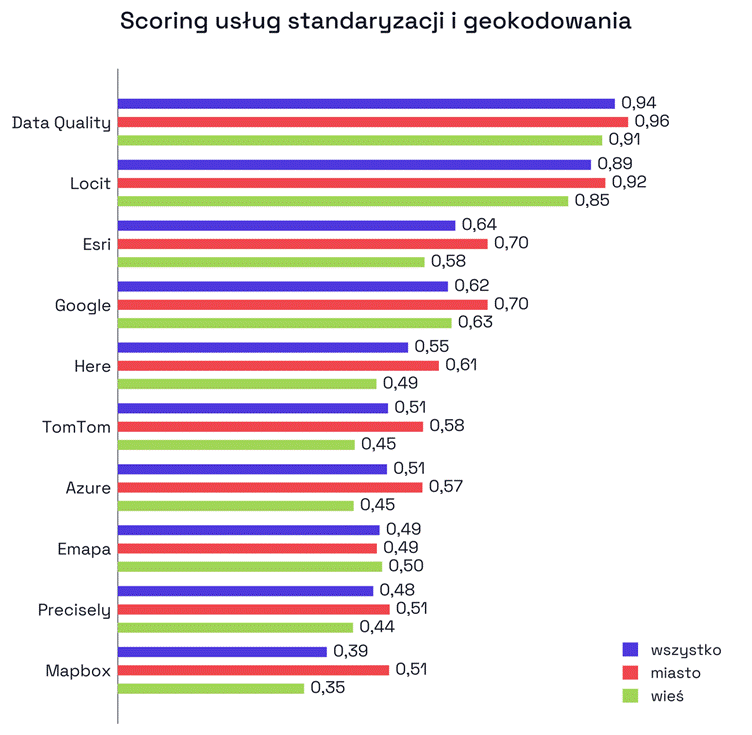
Ranking ogólny (SCORE) łączący standaryzację, geokodowanie i zaufanie - im wyżej, tym lepsza usługa (maksimum = 1,0).
Potwierdza to osobna analiza spójności adres-punkt - nawet wśród rekordów trafionych co do lokalizacji (błąd poniżej 50 m) pełna poprawność standaryzacji idzie z nią w parze przede wszystkim u dostawców lokalnych (Data Quality i Locit).
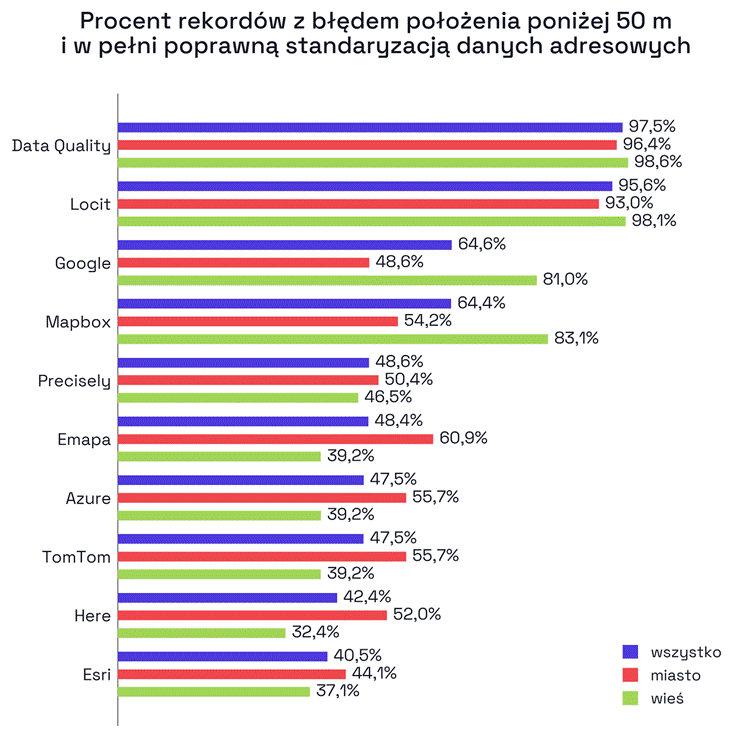
Procent rekordów z błędem poniżej 50 m i w pełni poprawną standaryzacją danych adresowych - im wyżej tym większa spójność adres-punkt (maksimum = 100%).
Miasto kontra wieś
W obu wymiarach powtarza się ta sama prawidłowość - usługi radzą sobie wyraźnie gorzej na adresach wiejskich niż w miastach - i w standaryzacji (brak podziału na ulice, większa wariantowość zapisu), i w geokodowaniu (grubszy ogon błędu). Narzędzie, które „wygląda dobrze” w uśrednieniu, może więc generować nieproporcjonalnie dużo wyjątków w procesach o zasięgu ogólnopolskim. Dlatego wszystkie wskaźniki liczyliśmy osobno dla miasta i wsi.
Jak ta analiza przekłada się na koszty?
Różnice jakości przekładają się wprost na koszty - niezależnie od ceny samego API. W symulacji dla 100 tys. przesyłek rocznie koszty dodatkowe (obsługa wyjątków, błędny routing, błędy fałszywie pewne) wahają się od ok. 101 tys. zł dla najlepszej usługi do ok. 897 tys. zł dla najsłabszej. To niemal 800 tys. zł różnicy roczni. Wniosek - usługa tania w zakupie potrafi być najdroższa w eksploatacji, dlatego dostawców warto porównywać w trybie całkowitego kosztu posiadania (TCO). Do raportu dołączyliśmy arkusz, w którym policzysz to na własnym wolumenie i stawkach.
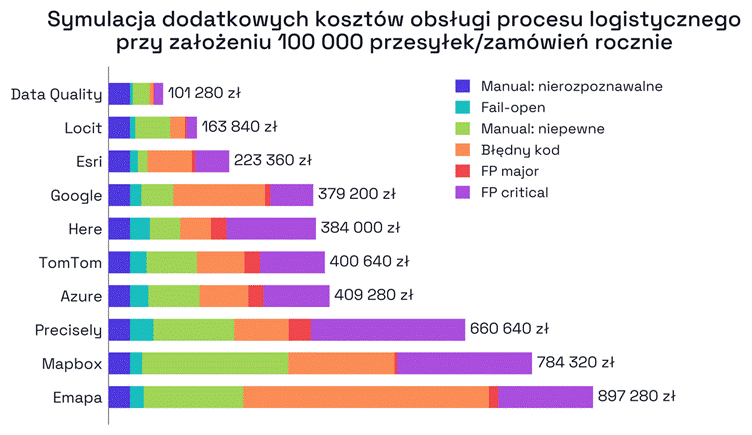
Symulacja dodatkowych kosztów obsługi procesu logistycznego przy założeniu 100 000 przesyłek / zamówień rocznie
Na co zwrócić uwagę, wybierając usługę?
- Oceniaj oba wymiary naraz. Dobra lokalizacja nie gwarantuje adresu użytecznego jako klucz - i odwrotnie.
- Patrz na ogon błędu, nie na średnią. O kosztach decydują rzadkie, ale duże pomyłki - sprawdzaj 95. percentyl i udział błędów powyżej 1 km, a nie samą średnią dokładność.
- Postaw na zgodność z TERYT. Zgodność nazw i identyfikatorów z rejestrem daje stabilny, niezależny od dostawcy klucz. W naszym badaniu zapewniały je tylko Data Quality i Locit.
- Analizuj miasto i wieś osobno. Jeśli działasz ogólnopolsko, uśredniony wynik może zamaskować słabość usługi na adresach wiejskich.
- Policz koszt na własnych danych. Podstaw swój wolumen i stawki w dołączonym arkuszu, zanim podejmiesz decyzję - cena API to zwykle ułamek całkowitego kosztu.
Dostęp do raportu
Pełny raport wraz z arkuszem symulacji udostępniamy bezpłatnie pod tym adresem. W razie pytań lub chęci omówienia wyników zachęcamy do kontaktu z nami.